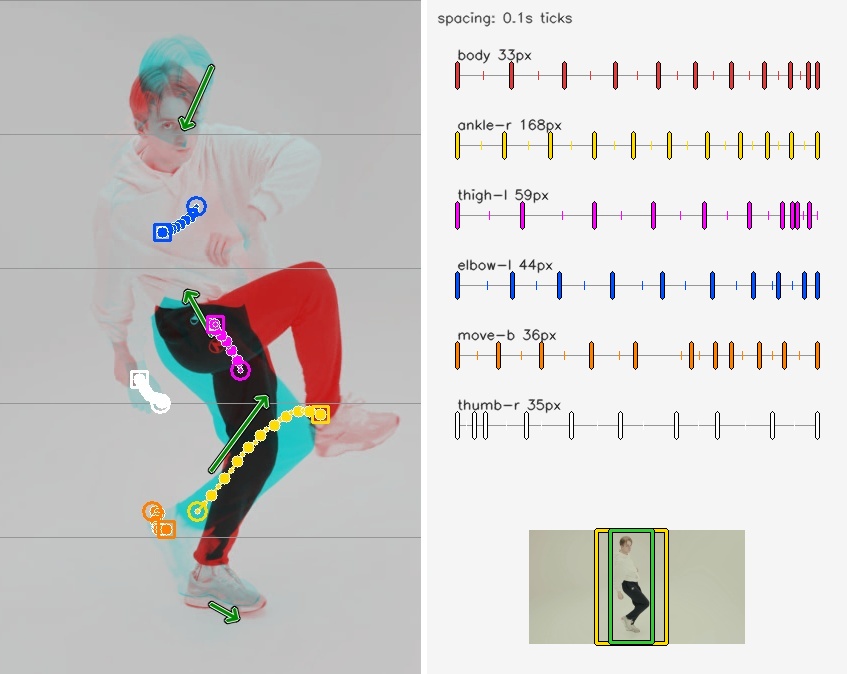
왜 만들었나
AI 에이전트는 영상을 몇 장의 정지 프레임으로 봅니다. 프레임 사이에 무엇이 얼마나, 어떤 완급으로 움직였는지는 보지 못합니다. 그래서 "참고 영상의 완급을 분석해서 같은 느낌으로 움직여 줘" 같은 일이 어렵습니다.
하는 일
- 샷(컷)을 나누고, 샷마다 몸·팔다리·카메라가 어느 방향으로 얼마나, 어떤 완급으로 움직였는지 짧은 글(look.md)로 적습니다.
- 첫 프레임과 마지막 프레임을 겹치고 추적한 점의 궤적을 그린 어니언 그림, 전체 프레임 모음, 확인이 필요한 구간의 촘촘한 프레임을 함께 만듭니다.
- 확실하지 않은 곳은 지어내지 않고 "모름"으로 남기며, 모든 내용을 원본 프레임 번호로 되짚을 수 있습니다.
- 사람 수를 먼저 훑어보고(crowd) 여러 명을 따로 추적합니다. 결과는 그림으로 점 위치를 먼저 확인한 뒤 수치를 읽도록 안내합니다.
맡은 일
방향과 요구사항, 검증 기준을 정하고 결과를 검토했습니다. 코드는 AI 팀(Claude·Codex)이 나눠 작성했고, 숫자 검증은 Codex가, 해석과 리뷰는 Claude가 주로 맡았습니다.
GitHub